Limpiar planillas de Excel complejas en R con {unpivotr}
Convertir planillas con múltiples encabezados, tablas dinámicas o pivotadas a dataframes
1/10/2026
Muchas planillas Excel presentan sus datos de forma no-rectangular; por ejemplo, con múltiples encabezados encima de las columnas, celdas combinadas que describen las variables bajo ellas, encabezados de variables en las filas, etc.
Datos desordenados
Veamos un ejemplo de datos desordenados:
| 2026 | ||||
|---|---|---|---|---|
| Grupo A | Grupo B | |||
| Variable | Variable 1 | Variable 2 | Variable 1 | Variable 2 |
| Observación 1 | 10 | 20 | 15 | 25 |
| Observación 2 | 12 | 22 | 17 | 27 |
La tabla anterior está desordenada porque tiene nombres de variables encima de nombres de variables, tienen valores como encabezados de columnas (años, grupos) los datos sobre las observaciones no están en sus propias columnas, y hay datos escondidos como nombres de columnas (los años).
Si bien este tipo de tablas pivotadas muchas veces facilita la lectura y mejora la densidad de información, da muchos problemas para manipular y transformar los datos:
¿Cómo filtrarías los datos de la Variable 1, si sale en 2 columnas distintas, que ni siquiera son consecutivas? Luego, ¿cómo seleccionarías los valores del Grupo B, si los datos están en 2 columnas, una de ellas sin siquiera tener etiqueta encima? O peor, imagina que la tabla abarca varios años, ¿cómo identificas en qué columnas están los valores de cierto año, si cada año abarca 4 columnas?
Un dolor de cabeza! 🫠
Así serían los mismos datos, pero en formato ordenado o tidy data, donde cada variable es una columna y cada observación es una fila:
| Año | Observación | Grupo | Variable 1 | Variable 2 |
|---|---|---|---|---|
| 2026 | 1 | A | 10 | 20 |
| 2026 | 1 | B | 15 | 25 |
| 2026 | 2 | A | 12 | 22 |
| 2026 | 2 | B | 17 | 27 |
El paquete {unpivotr} fue diseñado para despivotar este tipo de tablas y volver a estructurar la información desestructurada en filas y columnas.
install.packages("unpivotr")
library(unpivotr)
En código, si importamos la tabla Excel desordenada anterior con {readxl}, se vería así:
library(dplyr)
Attaching package: 'dplyr'

The following objects are masked from 'package:stats':

    filter, lag

The following objects are masked from 'package:base':

    intersect, setdiff, setequal, union
desorden <- tibble(
  `...1` = c(NA, NA, "Variable", "Observación 1", "Observación 2"),
  `...2` = c(2026, "Grupo A", "Variable 1", 10, 12),
  `...3` = c(NA, "Grupo A", "Variable 2", 20, 22),
  `...4` = c(NA, "Grupo B", "Variable 1", 15, 17),
  `...5` = c(NA, "Grupo B", "Variable 2", 25, 27)
)

desorden
# A tibble: 5 × 5
  ...1          ...2       ...3       ...4       ...5
  <chr>         <chr>      <chr>      <chr>      <chr>
1 <NA>          2026       <NA>       <NA>       <NA>
2 <NA>          Grupo A    Grupo A    Grupo B    Grupo B
3 Variable      Variable 1 Variable 2 Variable 1 Variable 2
4 Observación 1 10         20         15         25
5 Observación 2 12         22         17         27
Como vemos, se trata de una abominación alejada de los ojos de Dios. Para enfrentarnos a estos horrores, lo primero es deconstruir la tabla a sus meras celdas con as_cells(). Esto transforma la tabla en una nueva tabla de una fila por celda, que describe las filas y columnas donde se ubica cada celda, que es muy poco legible, pero es lo que nos permitirá reconstruirla.
library(unpivotr)

celdas <- as_cells(desorden)

celdas
# A tibble: 25 × 4
     row   col data_type chr
   <int> <int> <chr>     <chr>
 1     1     1 chr       <NA>
 2     2     1 chr       <NA>
 3     3     1 chr       Variable
 4     4     1 chr       Observación 1
 5     5     1 chr       Observación 2
 6     1     2 chr       2026
 7     2     2 chr       Grupo A
 8     3     2 chr       Variable 1
 9     4     2 chr       10
10     5     2 chr       12
# ℹ 15 more rows
Si ignoramos las primeras 3 columnas, vemos que tenemos todas las celdas en una sola columna (chr).
Ahora que tenemos la tabla tokenizada, procedemos a iluminar a esta bestia del abismo con la función behead(), o decapitar 🔪
Mirando la
tabla desordenada, vemos que la parte superior de la tabla tiene los años, así que decapitamos (behead()) la tabla por arriba ("up") para obtener la variable año:
celdas |>
  behead("up", "año")
# A tibble: 20 × 5
     row   col data_type chr           año
   <int> <int> <chr>     <chr>         <chr>
 1     2     1 chr       <NA>          <NA>
 2     3     1 chr       Variable      <NA>
 3     4     1 chr       Observación 1 <NA>
 4     5     1 chr       Observación 2 <NA>
 5     2     2 chr       Grupo A       2026
 6     3     2 chr       Variable 1    2026
 7     4     2 chr       10            2026
 8     5     2 chr       12            2026
 9     2     3 chr       Grupo A       <NA>
10     3     3 chr       Variable 2    <NA>
11     4     3 chr       20            <NA>
12     5     3 chr       22            <NA>
13     2     4 chr       Grupo B       <NA>
14     3     4 chr       Variable 1    <NA>
15     4     4 chr       15            <NA>
16     5     4 chr       17            <NA>
17     2     5 chr       Grupo B       <NA>
18     3     5 chr       Variable 2    <NA>
19     4     5 chr       25            <NA>
20     5     5 chr       27            <NA>
Vemos que aparece la columna con los años! Continuemos con el siguiente nivel de la tabla desde arriba hacia abajo, la variable grupo:
celdas |>
  behead("up", "año") |>
  behead("up", "grupo")
# A tibble: 15 × 6
     row   col data_type chr           año   grupo
   <int> <int> <chr>     <chr>         <chr> <chr>
 1     3     1 chr       Variable      <NA>  <NA>
 2     4     1 chr       Observación 1 <NA>  <NA>
 3     5     1 chr       Observación 2 <NA>  <NA>
 4     3     2 chr       Variable 1    2026  Grupo A
 5     4     2 chr       10            2026  Grupo A
 6     5     2 chr       12            2026  Grupo A
 7     3     3 chr       Variable 2    <NA>  Grupo A
 8     4     3 chr       20            <NA>  Grupo A
 9     5     3 chr       22            <NA>  Grupo A
10     3     4 chr       Variable 1    <NA>  Grupo B
11     4     4 chr       15            <NA>  Grupo B
12     5     4 chr       17            <NA>  Grupo B
13     3     5 chr       Variable 2    <NA>  Grupo B
14     4     5 chr       25            <NA>  Grupo B
15     5     5 chr       27            <NA>  Grupo B
Ahora se va notando que, por cada nivel que extraemos, creamos una columna que empieza a reconstuir la tabla que merecemos. Seguimos con la variable:
celdas |>
  behead("up", "año") |>
  behead("up", "grupo") |>
  behead("up", "variable")
# A tibble: 10 × 7
     row   col data_type chr           año   grupo   variable
   <int> <int> <chr>     <chr>         <chr> <chr>   <chr>
 1     4     1 chr       Observación 1 <NA>  <NA>    Variable
 2     5     1 chr       Observación 2 <NA>  <NA>    Variable
 3     4     2 chr       10            2026  Grupo A Variable 1
 4     5     2 chr       12            2026  Grupo A Variable 1
 5     4     3 chr       20            <NA>  Grupo A Variable 2
 6     5     3 chr       22            <NA>  Grupo A Variable 2
 7     4     4 chr       15            <NA>  Grupo B Variable 1
 8     5     4 chr       17            <NA>  Grupo B Variable 1
 9     4     5 chr       25            <NA>  Grupo B Variable 2
10     5     5 chr       27            <NA>  Grupo B Variable 2
Ahora podemos volver a mirar la
tabla desordenada y recordamos que queda la columna con los nombres de las observaciones al lado izquierdo ("left"):
tabla <- celdas |>
  behead("up", "año") |>
  behead("up", "grupo") |>
  behead("up", "variable") |>
  behead("left", "observacion")
Ahora a la columna chr, que contenía los valores crudos de la tabla, solamente le quedan los valores de cada celda, así que guardamos el resultado en un objeto nuevo y procedemos a limpiar un poquito:
tabla <- tabla |>
  select(año, observacion, grupo, variable,
         valor = chr)

tabla
# A tibble: 8 × 5
  año   observacion   grupo   variable   valor
  <chr> <chr>         <chr>   <chr>      <chr>
1 2026  Observación 1 Grupo A Variable 1 10
2 2026  Observación 2 Grupo A Variable 1 12
3 <NA>  Observación 1 Grupo A Variable 2 20
4 <NA>  Observación 2 Grupo A Variable 2 22
5 <NA>  Observación 1 Grupo B Variable 1 15
6 <NA>  Observación 2 Grupo B Variable 1 17
7 <NA>  Observación 1 Grupo B Variable 2 25
8 <NA>  Observación 2 Grupo B Variable 2 27
Vemos un último problema: el año no se propagó a todas las filas, porque la tabla tenía vacías esas columnas (dependía de que el/la usuario/a infiriera que el valor 2026 aplicaba a todas las columnas de la derecha). Podemos usar fill() de {tidyr} para rellenar hacia abajo, y luego limpiamos los valores de cada celda con str_remove() de {stringr}:
library(tidyr)
Attaching package: 'tidyr'

The following objects are masked from 'package:unpivotr':

    pack, unpack
library(stringr)

tabla <- tabla |>
  fill(año, .direction = "down") |>
  mutate(
    observacion = str_remove(observacion, "Observación "),
    grupo = str_remove(grupo, "Grupo "),
    variable = str_remove(variable, "Variable ")
  ) |>
  arrange(observacion)
Ahora podemos pivotar la tabla para obtener datos ordenados (tidy): una columna por cada variable, una fila por cada observación:
library(tidyr)

tabla <- tabla |>
  pivot_wider(
    names_from = variable,
    values_from = valor,
    names_prefix = "variable_")
| año | observacion | grupo | variable_1 | variable_2 |
|---|---|---|---|---|
| 2026 | 1 | A | 10 | 20 |
| 2026 | 1 | B | 15 | 25 |
| 2026 | 2 | A | 12 | 22 |
| 2026 | 2 | B | 17 | 27 |
Obtuvimos una tabla limpia, idéntica a la del ejemplo de más arriba, a partir de la tabla sucia!
{unpivotr} es demasiado útil para importar datos desordenados y volverlos en datos útiles para análisis. Ahora veremos dos ejemplos más para aprender a usarlo con datos reales!
Ejemplos con datos reales
Ahora que entendimos la lógica de {unpivotr} con un ejemplo mínimo, veamos cómo se aplica a dos planillas con datos reales.
Datos municipales
El primer ejemplo es una planilla descargada desde el Sistema Nacional de Información Municipal (SINIM), que entrega información financiera de todas las municipalidades de Chile.
Descargamos 3 variables de ingresos municipales para los años 2023 a 2025:
- Ingresos Municipales (Ingreso Total Percibido) (M$)
IADM01 - Ingresos por Fondo Común Municipal (M$)
IADM40 - Ingresos Propios Permanentes (IPP) (M$)
IADM41
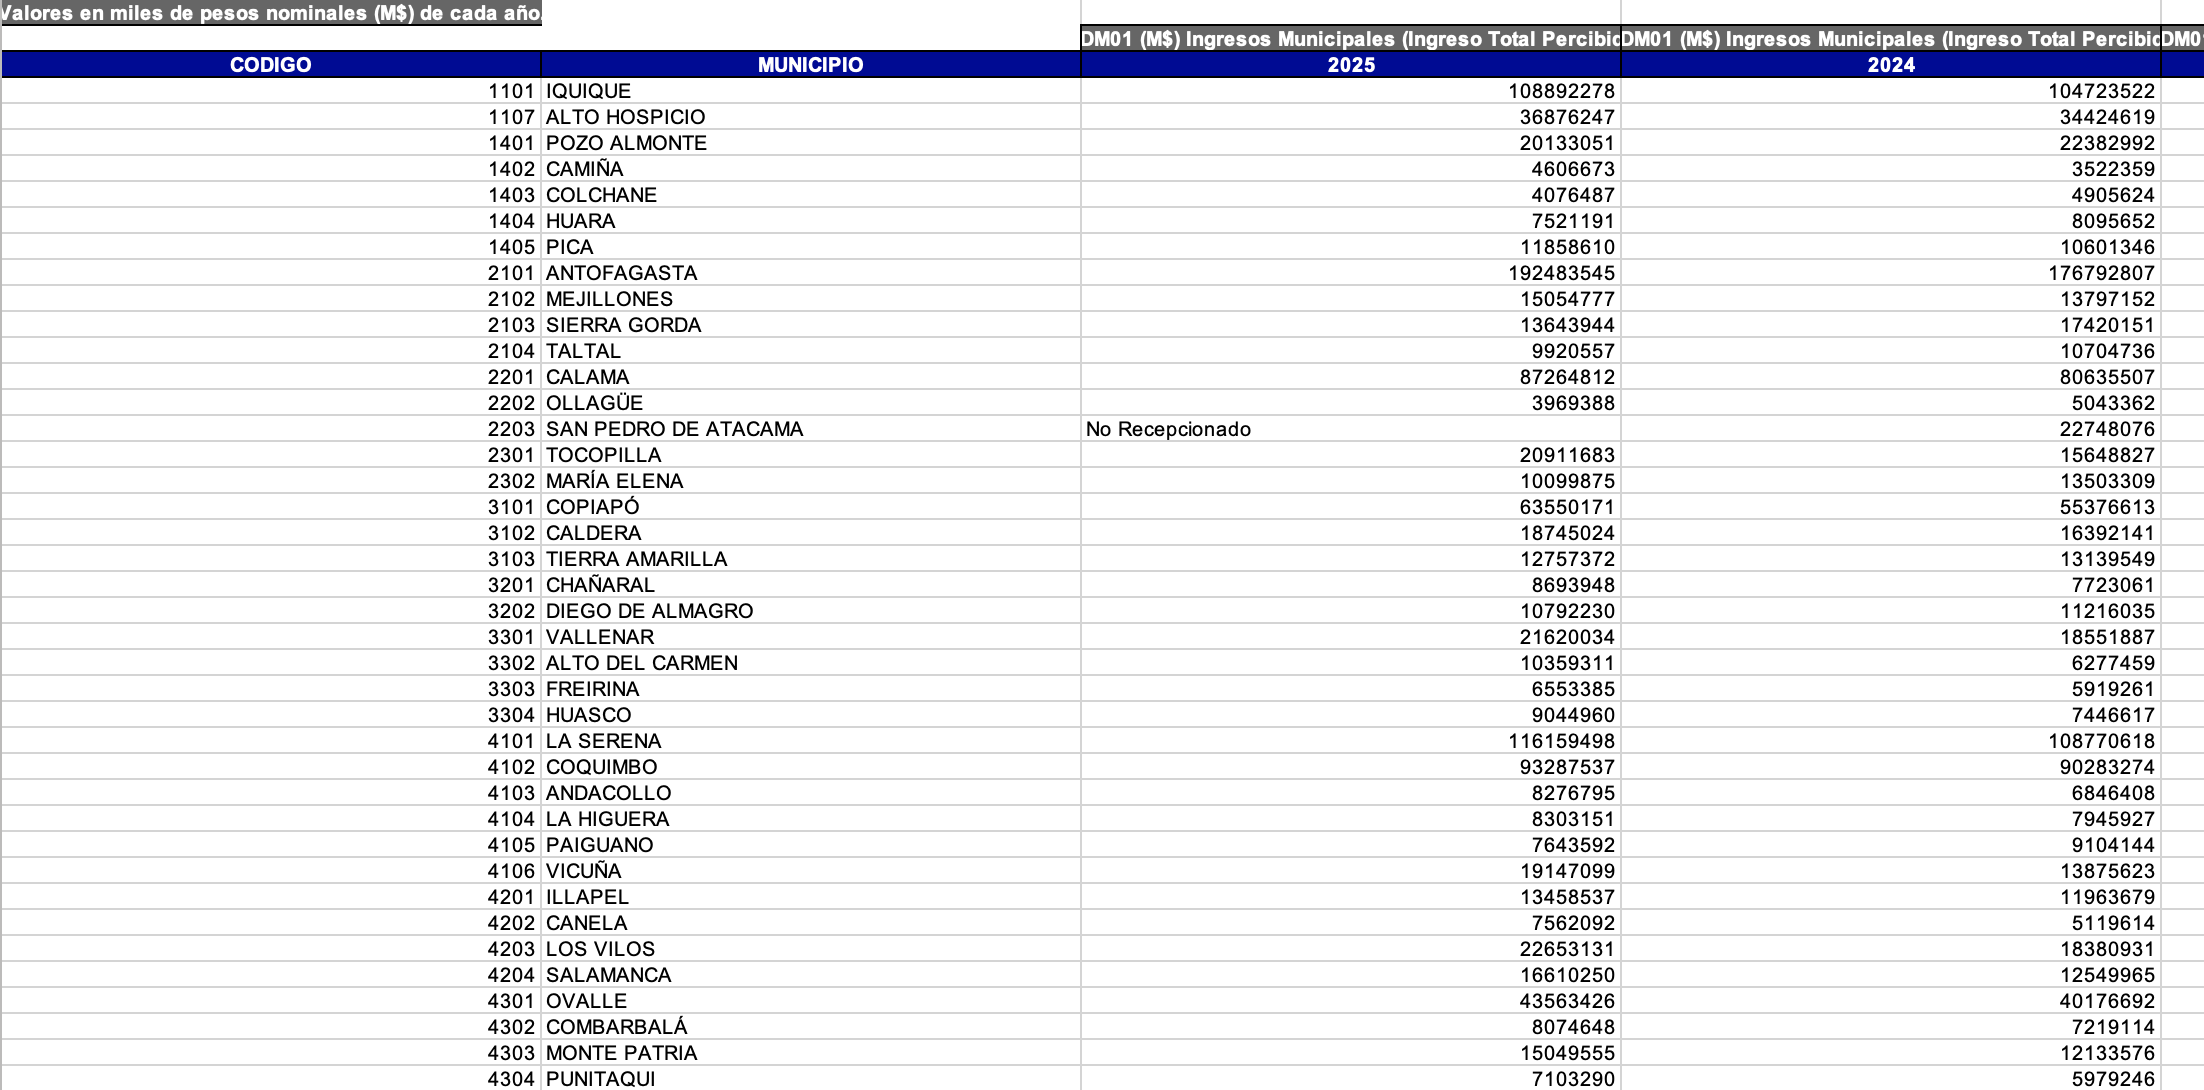
Cargamos los datos usando {openxlsx2}, sin nombres de columnas porque sabemos que los datos no vienen en una estructura confiable:
# install.packages('openxlsx2')
library(openxlsx2)
library(dplyr)

datos <- read_xlsx("datos_municipales_20260903181833_Sin-Correccion-Monetaria.xlsx",
                   col_names = FALSE) |>
  as_tibble()
Más o menos así se ve la planilla cargada en R:
| A | B | C | D | E | F | G | H |
|---|---|---|---|---|---|---|---|
| Valores en miles de pesos nominales (M$) de cada año. | NA | NA | NA | NA | NA | NA | NA |
| NA | NA | IADM01 (M$) Ingresos Municipales (Ingreso Total Percibido) | IADM01 (M$) Ingresos Municipales (Ingreso Total Percibido) | IADM01 (M$) Ingresos Municipales (Ingreso Total Percibido) | IADM40 (M$) Ingresos por Fondo Común Municipal | IADM40 (M$) Ingresos por Fondo Común Municipal | IADM40 (M$) Ingresos por Fondo Común Municipal |
| CODIGO | MUNICIPIO | 2025 | 2024 | 2023 | 2025 | 2024 | 2023 |
| 1101 | IQUIQUE | 108892278 | 104723522 | 98449509 | 8560862 | 7496937 | 6305296 |
| 1107 | ALTO HOSPICIO | 36876247 | 34424619 | 27951929 | 21540651 | 19217898 | 16489486 |
| 1401 | POZO ALMONTE | 20133051 | 22382992 | 17792283 | 5820144 | 4170737 | 3685890 |
Esta planilla es un asco! 🤮
Tiene varios problemas a la vez:
- La primera fila es solamente una nota al pie (el texto “valores en miles de pesos…”) que ocupa únicamente la primera columna
- La segunda fila contiene los códigos de las variables (
IADM01,IADM40,IADM41) - La tercera fila mezcla los nombres de columna reales (
CODIGO,MUNICIPIO) con los años de cada variable (2025, 2024, 2023) - Cada variable queda repartida en 3 columnas, una por año, en vez de existir una sola columna
Año - No hay una fila de nombres de columna claros!
El problema es porque los datos vienen pivotados: no se respetan los principios de los datos ordenados (tidy data), así que tenemos variables en filas y columnas, y variables sobre otras variables en un encabezado.
Como ya vimos, el primer paso de la limpieza para despivotar tablas es tokenizar la planilla con as_cells() para convertirla a una fila por celda:
library(unpivotr)

celdas <- datos |>
  as_cells()

celdas
# A tibble: 3,828 × 4
     row   col data_type chr
   <int> <int> <chr>     <chr>
 1     1     1 chr       Valores en miles de pesos nominales (M$) de cada año.
 2     2     1 chr       <NA>
 3     3     1 chr       CODIGO
 4     4     1 chr       1101
 5     5     1 chr       1107
 6     6     1 chr       1401
 7     7     1 chr       1402
 8     8     1 chr       1403
 9     9     1 chr       1404
10    10     1 chr       1405
# ℹ 3,818 more rows
La nota en la primera celda (una pésima práctica) queda convertida en una celda más, en la fila 1, columna 1. Podemos descartarla con un simple filtro antes de empezar a decapitar:
celdas <- celdas |>
  filter(row > 1)
Ahora, y siempre mirando la tabla original, aplicamos la misma lógica del ejemplo anterior: extraemos dos variables de arriba de la tabla (variable y año) y dos variables a la izquierda (codigo y comuna). Como ya vimos el procedimiento paso a paso, esta vez encadenamos los cuatro niveles de una sola vez:
tabla <- celdas |>
  behead(direction = "up", name = "variable") |>
  behead(direction = "up", name = "año") |>
  behead(direction = "left", name = "codigo") |>
  behead(direction = "left", name = "comuna")

tabla
# A tibble: 3,105 × 8
     row   col data_type chr       variable                  año   codigo comuna
   <int> <int> <chr>     <chr>     <chr>                     <chr> <chr>  <chr>
 1     4     3 chr       108892278 IADM01 (M$) Ingresos Mun… 2025  1101   IQUIQ…
 2     5     3 chr       36876247  IADM01 (M$) Ingresos Mun… 2025  1107   ALTO …
 3     6     3 chr       20133051  IADM01 (M$) Ingresos Mun… 2025  1401   POZO …
 4     7     3 chr       4606673   IADM01 (M$) Ingresos Mun… 2025  1402   CAMIÑA
 5     8     3 chr       4076487   IADM01 (M$) Ingresos Mun… 2025  1403   COLCH…
 6     9     3 chr       7521191   IADM01 (M$) Ingresos Mun… 2025  1404   HUARA
 7    10     3 chr       11858610  IADM01 (M$) Ingresos Mun… 2025  1405   PICA
 8    11     3 chr       192483545 IADM01 (M$) Ingresos Mun… 2025  2101   ANTOF…
 9    12     3 chr       15054777  IADM01 (M$) Ingresos Mun… 2025  2102   MEJIL…
10    13     3 chr       13643944  IADM01 (M$) Ingresos Mun… 2025  2103   SIERR…
# ℹ 3,095 more rows
Estamos casi! Convertimos las columnas a numéricas y sacamos las columnas innecesarias que describían las celdas:
tabla <- tabla |>
  mutate(valor = as.integer(chr)) |>
  select(-row, -col, -data_type, -chr) |>
  relocate(variable, .after = valor)
Warning: There was 1 warning in `mutate()`.
ℹ In argument: `valor = as.integer(chr)`.
Caused by warning:
! NAs introduced by coercion
Al convertir la columna valor a número aparece una advertencia de valores transformados en NA, pero son los valores que antes decían "No Recepcionado", debido a que esa municipalidad no entregó la información.
| año | codigo | comuna | valor | variable |
|---|---|---|---|---|
| 2025 | 1101 | IQUIQUE | 108892278 | IADM01 (M$) Ingresos Municipales (Ingreso Total Percibido) |
| 2025 | 1107 | ALTO HOSPICIO | 36876247 | IADM01 (M$) Ingresos Municipales (Ingreso Total Percibido) |
| 2025 | 1401 | POZO ALMONTE | 20133051 | IADM01 (M$) Ingresos Municipales (Ingreso Total Percibido) |
| 2025 | 1402 | CAMIÑA | 4606673 | IADM01 (M$) Ingresos Municipales (Ingreso Total Percibido) |
| 2025 | 1403 | COLCHANE | 4076487 | IADM01 (M$) Ingresos Municipales (Ingreso Total Percibido) |
| 2025 | 1404 | HUARA | 7521191 | IADM01 (M$) Ingresos Municipales (Ingreso Total Percibido) |
Con esto obtuvimos una tabla ordenada, rectangular, con variables claras y una fila por municipio ✨
Datos de empresas
El segundo ejemplo es todavía más desordenado: una planilla del Servicio de Impuestos Internos (SII) con estadísticas de personas naturales y sus montos de impuesto global complementario y único de segunda categoría, desagregados por región.
La planilla viene en formato .xlsb (Excel binario), que {openxlsx2} también puede leer. Pero también ábrela en Excel para entenderla visualmente.
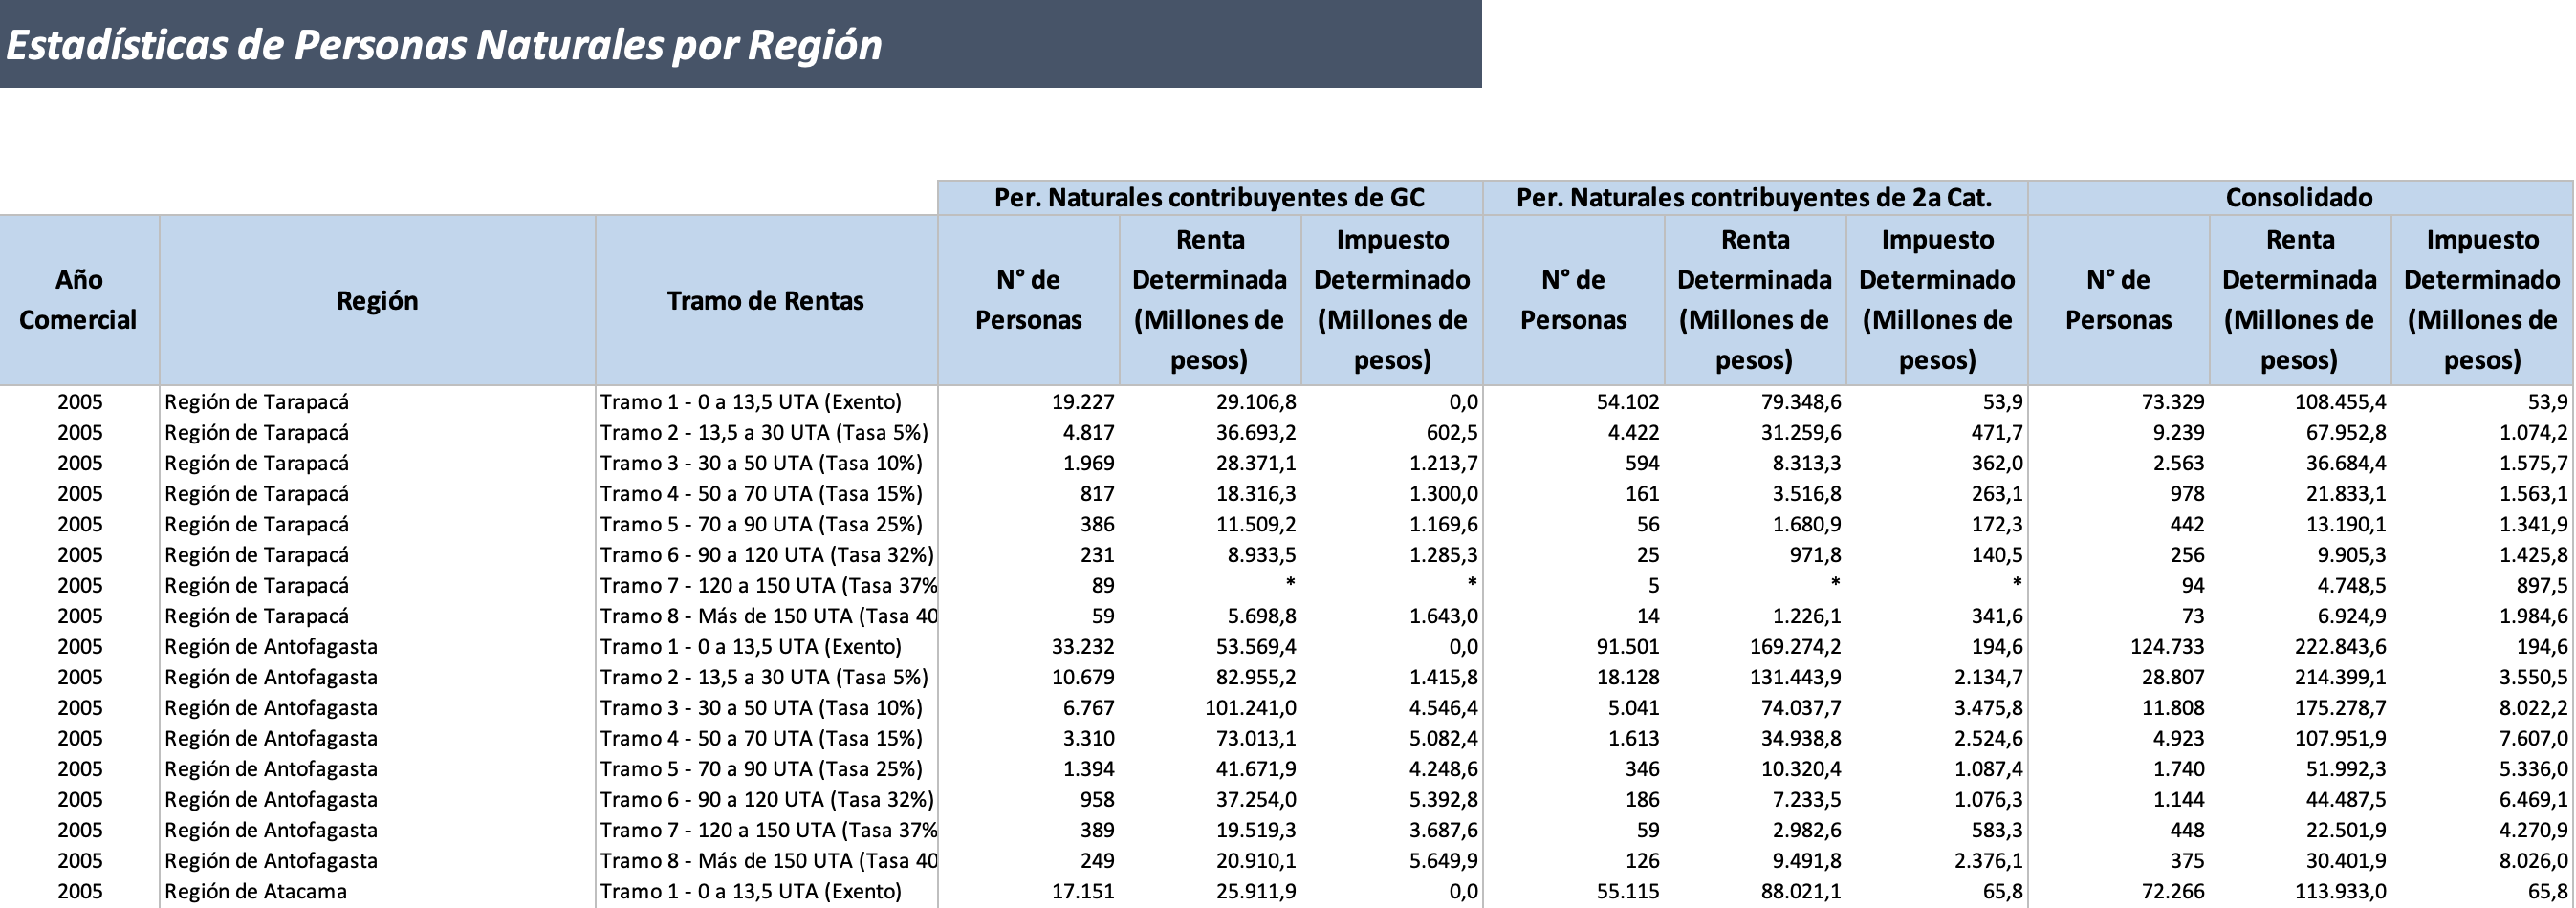
Si nos fijamos, la tabla tiene muchas filas vacías arriba, así que cargamos saltándonos 7 filas definiendo start_row = 7:
# install.packages('openxlsx2')
library(openxlsx2)
library(unpivotr)

# cargar
datos <- wb_read(
  "PUB_Region.xlsb",
  col_names = FALSE,
  start_row = 7
  ) |>
  as_tibble()
| A | B | C | D | E | F | G | H |
|---|---|---|---|---|---|---|---|
| NA | NA | NA | Per. Naturales contribuyentes de GC | NA | NA | Per. Naturales contribuyentes de 2a Cat. | NA |
| Año Comercial | Región | Tramo de Rentas | N° de Personas | Renta Determinada (Millones de pesos) | Impuesto Determinado (Millones de pesos) | N° de Personas | Renta Determinada (Millones de pesos) |
| 2005 | Región de Tarapacá | Tramo 1 - 0 a 13,5 UTA (Exento) | 19227 | 29106.8 | 0 | 54102 | 79348.60000000001 |
| 2005 | Región de Tarapacá | Tramo 2 - 13,5 a 30 UTA (Tasa 5%) | 4817 | 36693.2 | 602.5 | 4422 | 31259.6 |
| 2005 | Región de Tarapacá | Tramo 3 - 30 a 50 UTA (Tasa 10%) | 1969 | 28371.1 | 1213.7 | 594 | 8313.299999999999 |
| 2005 | Región de Tarapacá | Tramo 4 - 50 a 70 UTA (Tasa 15%) | 817 | 18316.3 | 1300 | 161 | 3516.8 |
Esta planilla tiene 2 niveles de encabezado hacia arriba (que podríamos llamar categoria y variable) y 3 niveles hacia la izquierda (año, región y tramo).
Ahora convertimos a celdas:
celdas <- as_cells(datos)
Recomiendo ir haciendo línea por línea la decapitación de la tabla, así vamos viendo cómo aparecen las columnas nuevas:
Empezamos por la izquierda:
celdas |>
  behead("left", "año")
# A tibble: 29,381 × 5
     row   col data_type chr                año
   <int> <int> <chr>     <chr>              <chr>
 1     1     2 chr       <NA>               <NA>
 2     2     2 chr       Región             Año Comercial
 3     3     2 chr       Región de Tarapacá 2005
 4     4     2 chr       Región de Tarapacá 2005
 5     5     2 chr       Región de Tarapacá 2005
 6     6     2 chr       Región de Tarapacá 2005
 7     7     2 chr       Región de Tarapacá 2005
 8     8     2 chr       Región de Tarapacá 2005
 9     9     2 chr       Región de Tarapacá 2005
10    10     2 chr       Región de Tarapacá 2005
# ℹ 29,371 more rows
Seguimos extrayendo las variables de la izquierda…
celdas |>
  behead("left", "año") |>
  behead("left", "region") |>
  behead("left", "tramo")
# A tibble: 24,039 × 7
     row   col data_type chr                                 año    region tramo
   <int> <int> <chr>     <chr>                               <chr>  <chr>  <chr>
 1     1     4 chr       Per. Naturales contribuyentes de GC <NA>   <NA>   <NA>
 2     2     4 chr       N° de Personas                      Año C… Región Tram…
 3     3     4 chr       19227                               2005   Regió… Tram…
 4     4     4 chr       4817                                2005   Regió… Tram…
 5     5     4 chr       1969                                2005   Regió… Tram…
 6     6     4 chr       817                                 2005   Regió… Tram…
 7     7     4 chr       386                                 2005   Regió… Tram…
 8     8     4 chr       231                                 2005   Regió… Tram…
 9     9     4 chr       89                                  2005   Regió… Tram…
10    10     4 chr       59                                  2005   Regió… Tram…
# ℹ 24,029 more rows
Ya empieza a tomar forma! Ahora las de arriba:
tabla <- celdas |>
  behead("left", "año") |>
  behead("left", "region") |>
  behead("left", "tramo") |>
  behead("up", "categoria") |>
  behead("up", "variable")

tabla
# A tibble: 24,021 × 9
     row   col data_type chr   año   region             tramo categoria variable
   <int> <int> <chr>     <chr> <chr> <chr>              <chr> <chr>     <chr>
 1     3     4 chr       19227 2005  Región de Tarapacá Tram… Per. Nat… N° de P…
 2     4     4 chr       4817  2005  Región de Tarapacá Tram… Per. Nat… N° de P…
 3     5     4 chr       1969  2005  Región de Tarapacá Tram… Per. Nat… N° de P…
 4     6     4 chr       817   2005  Región de Tarapacá Tram… Per. Nat… N° de P…
 5     7     4 chr       386   2005  Región de Tarapacá Tram… Per. Nat… N° de P…
 6     8     4 chr       231   2005  Región de Tarapacá Tram… Per. Nat… N° de P…
 7     9     4 chr       89    2005  Región de Tarapacá Tram… Per. Nat… N° de P…
 8    10     4 chr       59    2005  Región de Tarapacá Tram… Per. Nat… N° de P…
 9    11     4 chr       33232 2005  Región de Antofag… Tram… Per. Nat… N° de P…
10    12     4 chr       10679 2005  Región de Antofag… Tram… Per. Nat… N° de P…
# ℹ 24,011 more rows
Con los 5 niveles extraídos, nos quedamos solamente con esas columnas y el valor de cada celda:
tabla <- tabla |>
  mutate(valor = as.integer(chr)) |>
  select(-row, -col, -data_type, -chr)
Warning: There was 1 warning in `mutate()`.
ℹ In argument: `valor = as.integer(chr)`.
Caused by warning:
! NAs introduced by coercion
tabla
# A tibble: 24,021 × 6
   año   region                tramo                    categoria variable valor
   <chr> <chr>                 <chr>                    <chr>     <chr>    <int>
 1 2005  Región de Tarapacá    Tramo 1 - 0 a 13,5 UTA … Per. Nat… N° de P… 19227
 2 2005  Región de Tarapacá    Tramo 2 - 13,5 a 30 UTA… Per. Nat… N° de P…  4817
 3 2005  Región de Tarapacá    Tramo 3 - 30 a 50 UTA (… Per. Nat… N° de P…  1969
 4 2005  Región de Tarapacá    Tramo 4 - 50 a 70 UTA (… Per. Nat… N° de P…   817
 5 2005  Región de Tarapacá    Tramo 5 - 70 a 90 UTA (… Per. Nat… N° de P…   386
 6 2005  Región de Tarapacá    Tramo 6 - 90 a 120 UTA … Per. Nat… N° de P…   231
 7 2005  Región de Tarapacá    Tramo 7 - 120 a 150 UTA… Per. Nat… N° de P…    89
 8 2005  Región de Tarapacá    Tramo 8 - Más de 150 UT… Per. Nat… N° de P…    59
 9 2005  Región de Antofagasta Tramo 1 - 0 a 13,5 UTA … Per. Nat… N° de P… 33232
10 2005  Región de Antofagasta Tramo 2 - 13,5 a 30 UTA… Per. Nat… N° de P… 10679
# ℹ 24,011 more rows
Revisemos que la variable categoria, que es la más extraña en la tabla, haya quedado bien extraída:
tabla |>
  distinct(categoria)
# A tibble: 4 × 1
  categoria
  <chr>
1 Per. Naturales contribuyentes de GC
2 <NA>
3 Per. Naturales contribuyentes de 2a Cat.
4 Consolidado
Aparece un valor NA! En cambio, la columna variable sí se extrajo completa para todas las columnas:
tabla |>
  distinct(categoria, variable)
# A tibble: 5 × 2
  categoria                                variable
  <chr>                                    <chr>
1 Per. Naturales contribuyentes de GC      N° de Personas
2 <NA>                                     Renta Determinada (Millones de pesos)
3 <NA>                                     Impuesto Determinado (Millones de pe…
4 Per. Naturales contribuyentes de 2a Cat. N° de Personas
5 Consolidado                              N° de Personas
Esto pasa porque, en la planilla original, el encabezado de cada categoria corresponde a una celda combinada que abarca 3 columnas (una por cada variable), o sea que, de las 3 columnas, el texto solo aparece en la primera, y las otras dos están vacías, así que salen como NA dado que se asume que la persona que mira la tabla se imagina que el primer valor se repite hacia el lado. Por eso behead("up", "categoria") no tiene nada que extraer para ellas y quedan en NA.
Veamos el problema en un caso puntual:
# ver el problema
tabla |>
  filter(
    region == "Región de Coquimbo",
    tramo == "Tramo 1 - 0 a 13,5 UTA (Exento)",
    año == 2015
  ) |>
  select(-region)
# A tibble: 9 × 5
  año   tramo                           categoria                variable  valor
  <chr> <chr>                           <chr>                    <chr>     <int>
1 2015  Tramo 1 - 0 a 13,5 UTA (Exento) Per. Naturales contribu… N° de P…  55840
2 2015  Tramo 1 - 0 a 13,5 UTA (Exento) <NA>                     Renta D… 169887
3 2015  Tramo 1 - 0 a 13,5 UTA (Exento) <NA>                     Impuest…      0
4 2015  Tramo 1 - 0 a 13,5 UTA (Exento) Per. Naturales contribu… N° de P… 146253
5 2015  Tramo 1 - 0 a 13,5 UTA (Exento) <NA>                     Renta D… 381320
6 2015  Tramo 1 - 0 a 13,5 UTA (Exento) <NA>                     Impuest…    953
7 2015  Tramo 1 - 0 a 13,5 UTA (Exento) Consolidado              N° de P… 202093
8 2015  Tramo 1 - 0 a 13,5 UTA (Exento) <NA>                     Renta D… 551207
9 2015  Tramo 1 - 0 a 13,5 UTA (Exento) <NA>                     Impuest…    953
De las 9 filas, solamente las que corresponden a la primera variable de cada categoría (N° de Personas) quedaron con su categoria bien puesta; las otras 2 de cada grupo quedaron en NA.
Entonces la solución es repetir el valor de categoria con fill() hacia abajo, para rellenar esos NA, igual como hicimos con la variable año en el ejemplo anterior:
# rellenar
tabla <- tabla |>
  fill(categoria, .direction = "down")
Ahora sí! Y así se ve la tablita ordenada, filtrada:
tabla |>
  filter(
    region == "Región de Coquimbo",
    tramo == "Tramo 1 - 0 a 13,5 UTA (Exento)",
    año == 2015
  )
| año | region | tramo | categoria | variable | valor |
|---|---|---|---|---|---|
| 2015 | Región de Coquimbo | Tramo 1 - 0 a 13,5 UTA (Exento) | Per. Naturales contribuyentes de GC | N° de Personas | 55840 |
| 2015 | Región de Coquimbo | Tramo 1 - 0 a 13,5 UTA (Exento) | Per. Naturales contribuyentes de GC | Renta Determinada (Millones de pesos) | 169887 |
| 2015 | Región de Coquimbo | Tramo 1 - 0 a 13,5 UTA (Exento) | Per. Naturales contribuyentes de GC | Impuesto Determinado (Millones de pesos) | 0 |
| 2015 | Región de Coquimbo | Tramo 1 - 0 a 13,5 UTA (Exento) | Per. Naturales contribuyentes de 2a Cat. | N° de Personas | 146253 |
| 2015 | Región de Coquimbo | Tramo 1 - 0 a 13,5 UTA (Exento) | Per. Naturales contribuyentes de 2a Cat. | Renta Determinada (Millones de pesos) | 381320 |
| 2015 | Región de Coquimbo | Tramo 1 - 0 a 13,5 UTA (Exento) | Per. Naturales contribuyentes de 2a Cat. | Impuesto Determinado (Millones de pesos) | 953 |
Mucho más claro!
Para terminar, en vez de dejar las 3 variables apiladas en una sola columna valor (formato largo), conviene
transformarlas a formato ancho con pivot_wider(), para que cada variable (N° de Personas, Renta Determinada, Impuesto Determinado) quede en su propia columna:
library(tidyr)

tabla_wide <- tabla |>
  pivot_wider(
    names_from = variable,
    values_from = valor
  )
| año | region | tramo | categoria | N° de Personas | Renta Determinada (Millones de pesos) | Impuesto Determinado (Millones de pesos) |
|---|---|---|---|---|---|---|
| 2005 | Región de Tarapacá | Tramo 1 - 0 a 13,5 UTA (Exento) | Per. Naturales contribuyentes de GC | 19227 | 29106 | 0 |
| 2005 | Región de Tarapacá | Tramo 2 - 13,5 a 30 UTA (Tasa 5%) | Per. Naturales contribuyentes de GC | 4817 | 36693 | 602 |
| 2005 | Región de Tarapacá | Tramo 3 - 30 a 50 UTA (Tasa 10%) | Per. Naturales contribuyentes de GC | 1969 | 28371 | 1213 |
| 2005 | Región de Tarapacá | Tramo 4 - 50 a 70 UTA (Tasa 15%) | Per. Naturales contribuyentes de GC | 817 | 18316 | 1300 |
| 2005 | Región de Tarapacá | Tramo 5 - 70 a 90 UTA (Tasa 25%) | Per. Naturales contribuyentes de GC | 386 | 11509 | 1169 |
| 2005 | Región de Tarapacá | Tramo 6 - 90 a 120 UTA (Tasa 32%) | Per. Naturales contribuyentes de GC | 231 | 8933 | 1285 |
La tabla del terror quedó con una fila por región, tramo, año y categoría de contribuyente, con sus 3 variables como columnas.
Y así, decapitando planillas nivel por nivel, pasamos de dos tablas de Excel verdaderamente infernales a datos ordenados y listos para analizar 🎉
Publicaciones sobre tablas


Publicaciones sobre limpieza de datos